
Algoritma, belirli bir problemi çözmek veya belirlenmiş bir görevi yerine getirmek amacıyla oluşturulan, tanımlı adımlar ve kurallar bütünüdür. Dijital sistemlerde algoritmalar; verilerin işlenmesi, sınıflandırılması, karşılaştırılması ve belirli ölçütlere göre sonuç üretilmesi gibi çeşitli işlevler üstlenmektedir. Günlük yaşamda algoritmalar farklı biçimlerde karşımıza çıkmaktadır. Bir arama motorunun sorguya ilişkin sonuçları sıralaması, bir sosyal medya platformunun kullanıcıya gösterilecek içerikleri belirlemesi veya bir öneri sisteminin önceki davranışlara dayalı olarak yeni içerikler sunması, algoritmik süreçlere örnek olarak gösterilebilir. Ancak algoritmalar yalnızca teknik işlemleri gerçekleştiren araçlar olarak değerlendirilmemelidir. Algoritmik sistemler, hangi bilginin görünür hâle geleceğini, hangi içeriklerin önceliklendirileceğini ve kullanıcının hangi seçeneklerle karşılaşacağını etkileyebilmektedir. Bu nedenle algoritmalar, dijital bilgi ortamının görünmeyen ancak önemli bileşenlerinden biridir.
Dijital teknolojilerin yaygınlaşmasıyla birlikte bireylerin bilgiye erişim biçimleri önemli ölçüde dönüşmüştür. Günümüzde arama motorları, sosyal medya platformları, öneri sistemleri ve yapay zekâ destekli uygulamalar, kullanıcıların karşılaştığı bilgi ve içeriklerin belirlenmesinde aktif rol oynamaktadır. Bu sistemlerin önemli bir bölümü, büyük miktardaki veri içerisinden belirli içerikleri seçmek, sınıflandırmak, önceliklendirmek ve kullanıcılara sunmak amacıyla algoritmik süreçlerden yararlanmaktadır. Dolayısıyla dijital bilgi ortamında karşılaşılan içerikler yalnızca kullanıcıların yaptığı tercihlerin değil, aynı zamanda bu tercihleri işleyen ve belirli kurallar doğrultusunda sonuç üreten algoritmaların da etkisiyle şekillenmektedir. Algoritmaların bilgiye erişim sürecindeki rolünün artması, kullanıcıların yalnızca bilgi kaynaklarını değil, bu kaynaklara erişimi sağlayan teknolojik sistemleri de anlamasını gerekli kılmaktadır.
Bir kullanıcı dijital bir sistemde arama gerçekleştirdiğinde ekranda genellikle yalnızca sonuçlarla karşılaşır. Ancak bu sonuçların oluşturulmasından önce çeşitli algoritmik işlemler gerçekleşmektedir. Basitleştirilmiş bir bilgi erişim süreci şu şekilde düşünülebilir.
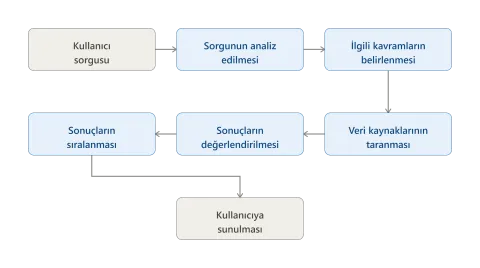
Bu süreçte sistem, kullanıcının sorgusunu doğrudan eşleştirmekle sınırlı kalmayabilir. Kullanılan teknolojiye bağlı olarak sorgunun anlamı analiz edilebilir, ilişkili kavramlar belirlenebilir, sonuçlar belirli ölçütlere göre sıralanabilir veya kullanıcının önceki davranışlarından elde edilen veriler değerlendirmeye alınabilir. Dolayısıyla kullanıcı tarafından görülen sonuç listesi, yalnızca mevcut bilgi kaynaklarının doğrudan bir yansıması değildir. Bu liste, veri kaynakları ile algoritmik karar süreçlerinin birlikte oluşturduğu bir çıktı olarak değerlendirilmelidir.
Algoritma okuryazarlığı, bireylerin günlük yaşamlarında karşılaştıkları algoritmik sistemlerin temel çalışma mantığını anlamalarını ve bu sistemlerin kararları üzerindeki etkilerini eleştirel bir biçimde değerlendirebilmelerini ifade eden bir kavramdır. Algoritma okuryazarlığı, bireylerin algoritma geliştirebilmesini veya programlama bilgisine sahip olmasını gerektirmez. Bunun yerine, algoritmik sistemlerin belirli veriler, kurallar ve tasarım tercihleri doğrultusunda çalıştığının farkında olunmasını ve bu süreçlerin sonuçlarının sorgulanabilmesini amaçlar. Bu bağlamda algoritma okuryazarlığı aşağıdaki sorular etrafında şekillenmektedir:
- Bir sistem belirli bir sonucu neden öncelikli olarak göstermektedir?
- Algoritma karar verirken hangi veri ve ölçütlerden yararlanmaktadır?
- Hangi içerikler görünür hâle gelirken hangileri görünmez kalmaktadır?
- Sonuçların sıralanmasında hangi faktörler etkili olmaktadır?
- Algoritmik sistemlerin ürettiği sonuçlarda hata veya önyargı bulunabilir mi?
- Kullanıcı davranışları sistemin gelecekteki kararlarını etkileyebilir mi?
Algoritma okuryazarlığının temel amacı, algoritmik sistemlerin ürettiği sonuçları sorgulamadan kabul etmek yerine, bu sonuçların nasıl ve hangi koşullar altında ortaya çıktığını eleştirel biçimde değerlendirebilmektir.
Bilgi okuryazarlığı, bireylerin bilgi gereksinimlerini tanımlama, uygun bilgi kaynaklarına erişme, bilgiyi değerlendirme ve etik biçimde kullanma becerilerini kapsamaktadır. Ancak dijital bilgi ortamlarının dönüşümüyle birlikte bilgiye erişim süreci giderek daha fazla algoritmik sistemler aracılığıyla gerçekleşmektedir. Arama motorları, keşif sistemleri ve yapay zekâ destekli araçlar yalnızca bilgi kaynaklarına erişim sağlamamakta; aynı zamanda bilgilerin seçilmesi, sıralanması ve kullanıcıya sunulması süreçlerinde de rol üstlenmektedir. Bu durum, geleneksel bilgi okuryazarlığı becerilerine yeni bir boyut eklemektedir.
Geleneksel bilgi okuryazarlığı çerçevesinde temel sorular şunlardır:
- Bilgiye nereden erişebilirim?
- Kaynak güvenilir midir?
- Bilgi doğru ve güncel midir?
Algoritma okuryazarlığı ise bu sorulara aşağıdaki boyutları eklemektedir:
- Bu bilgi neden karşıma çıktı?
- Sistem hangi kaynaklar arasından seçim yaptı?
- Hangi bilgiler sonuçlarda görünür olmadı?
- Sonuçlar hangi ölçütlere göre sıralandı?
- Algoritmik süreçler bilgiye erişimimi nasıl etkiliyor?
Bu perspektiften bakıldığında algoritma okuryazarlığı, bilgi okuryazarlığının alternatifi değil; dijital ve yapay zekâ destekli bilgi ortamlarında onu tamamlayan önemli bir beceri alanı olarak değerlendirilebilir. Algoritmalar günümüzde yalnızca bilgiyi bulmayı kolaylaştıran teknik araçlar değildir. Aynı zamanda bilgiye erişim sürecinin nasıl gerçekleştiğini etkileyen karar mekanizmalarının bir parçasıdır. Bir algoritmik sistemin çalışma biçimi;
- hangi kaynakların taranacağını,
- hangi içeriklerin önceliklendirileceğini,
- sonuçların nasıl sıralanacağını,
- kullanıcının hangi bilgilerle karşılaşacağını etkileyebilmektedir.
Bu nedenle dijital bilgi ortamında eleştirel düşünme yalnızca bilginin içeriğini değerlendirmeyi değil, bilginin kullanıcıya ulaşmasını sağlayan sistemleri de sorgulamayı gerektirmektedir. Algoritma okuryazarlığı, kullanıcıların algoritmik sistemlerin tamamen nesnel veya tarafsız olduğu varsayımını sorgulamalarına yardımcı olur. Her algoritmik sistem; belirli veri kaynakları, teknik tercihler, sınıflandırma yöntemleri ve tasarım kararları çerçevesinde çalışmaktadır. Dolayısıyla algoritmalar tarafından üretilen sonuçlar, mutlak ve değişmez gerçeklikler olarak değil; belirli sistemsel süreçlerin çıktıları olarak değerlendirilmelidir.
Bilgiye erişmek kadar, bilginin nasıl erişilebilir hâle geldiğini anlamak da önemlidir.
Algoritma okuryazarlığı, kullanıcıların yalnızca ekranda karşılaştıkları sonuçlara odaklanmasını değil, bu sonuçların arkasındaki veri, süreç ve karar mekanizmalarını da sorgulamasını gerektirir. Özellikle yapay zekâ destekli bilgi erişim sistemlerinin yaygınlaşmasıyla birlikte bu sorgulama daha da önemli hâle gelmektedir. Çünkü yeni nesil sistemler yalnızca bilgi kaynaklarını listelemekle kalmamakta; kullanıcı sorgularını yorumlayabilmekte, ilişkili bilgileri seçebilmekte ve farklı kaynaklardan elde edilen bilgileri sentezleyerek yanıtlar oluşturabilmektedir. Bu nedenle algoritma okuryazarlığı, günümüz dijital bilgi ekosisteminde eleştirel ve bilinçli bilgi kullanımının önemli bileşenlerinden biri olarak ele alınmalıdır.
Bilgi Merkezleri, geleneksel olarak sahip oldukları basılı ve elektronik kaynakların düzenlenmesi ve erişilebilir hâle getirilmesi amacıyla çeşitli bilgi erişim sistemlerinden yararlanmıştır. Çevrimiçi kataloglar (OPAC), kullanıcıların Bilgi Merkezi koleksiyonlarında yer alan kaynakları bibliyografik kayıtlar aracılığıyla aramasına olanak sağlamıştır. Ancak elektronik kaynakların yaygınlaşmasıyla birlikte bilgi erişim ortamı önemli ölçüde değişmiştir. Kitap ve süreli yayınların yanı sıra e-kitaplar, elektronik dergiler, makaleler, veri tabanları, açık erişim kaynaklar ve kurumsal arşivler de Bilgi Merkezi koleksiyonlarının bir parçası hâline gelmiştir. Bu çeşitlilik, kullanıcıların farklı sistemlerde ayrı ayrı arama yapmasını gerektiren parçalı bir bilgi erişim ortamı oluşturmuştur. Bilgi Merkezi web keşif sistemleri, bu parçalı yapıyı mümkün olduğunca bütünleştirerek kullanıcıların farklı kaynak türlerine tek bir arayüz üzerinden erişebilmesini sağlamak amacıyla geliştirilmiştir.
Bilgi Merkezi web keşif aracı, bir Bilgi Merkezi'nin sahip olduğu veya erişim sağladığı farklı bilgi kaynaklarını ortak bir arama ortamında bir araya getiren bilgi erişim sistemleridir. Bu sistemler genel olarak kullanıcılara;
- basılı kitaplar,
- elektronik kitaplar,
- akademik dergi makaleleri,
- süreli yayınlar,
- tezler,
- kurumsal arşiv içerikleri,
- açık erişim kaynaklar gibi farklı türdeki bilgi kaynaklarını tek bir arayüz üzerinden keşfetme olanağı sunmaktadır.
Ancak keşif sistemlerinin temel işlevi yalnızca kaynakları bir araya getirmek değildir. Aynı zamanda kullanıcı sorgularının analiz edilmesi, ilgili kayıtların belirlenmesi ve sonuçların belirli ölçütlere göre sıralanması gibi bilgi erişim süreçlerini de yönetmektedir. Bu nedenle bir web keşif sistemi, yalnızca bir katalog veya arama kutusu olarak değil; farklı veri kaynakları ile kullanıcı arasındaki bilgi erişim sürecini yöneten bir sistem olarak değerlendirilmelidir.
Geleneksel bilgi erişim sistemlerinde kullanıcılar genellikle belirli anahtar kelimeler aracılığıyla arama gerçekleştirmektedir. Sistem, kullanıcının girdiği terimleri bibliyografik kayıtlar ve indekslenen veriler içerisinde eşleştirmeye çalışmaktadır.
- Örneğin bir kullanıcı "climate change and migration" şeklinde bir arama yaptığında sistem, ilgili terimleri başlık, özet, konu başlığı veya diğer indeks alanlarında arayabilir.
Bununla birlikte, kullanıcıların bilgi gereksinimleri her zaman doğru anahtar kelimelerle ifade edilemeyebilir. Aynı kavram farklı disiplinlerde veya kaynaklarda farklı terimlerle ifade edilebilir.
Örneğin:
- climate change
- global warming
- climate crisis
- environmental change ifadeleri farklı bağlamlarda birbiriyle ilişkili kavramlar olarak kullanılabilmektedir.
Benzer şekilde: "migration displacement", "human mobility", "climate migration" ifadeleri de aynı araştırma konusu içerisinde farklı anlam ilişkilerine sahip olabilir. Yapay zekâ ve doğal dil işleme teknolojilerinin bilgi erişim sistemlerine entegre edilmesiyle birlikte, kullanıcı sorgularının yalnızca kelime düzeyinde değil, anlam ve bağlam açısından da değerlendirilmesine yönelik yeni yaklaşımlar ortaya çıkmış ve araçlar bu doğrultuda çalışmaya başlamıştır.
Yapay zekâ teknolojileri, bilgi erişim süreçlerinin farklı aşamalarında kullanılabilmektedir. Bu teknolojiler, özellikle doğal dil işleme, makine öğrenmesi ve büyük dil modelleri aracılığıyla kullanıcı sorgularının yorumlanması ve bilgi kaynaklarıyla ilişkilendirilmesi konusunda yeni olanaklar sunmaktadır. Yapay zekâ destekli bir bilgi erişim sisteminde süreç genel olarak şu aşamalardan oluşabilir.
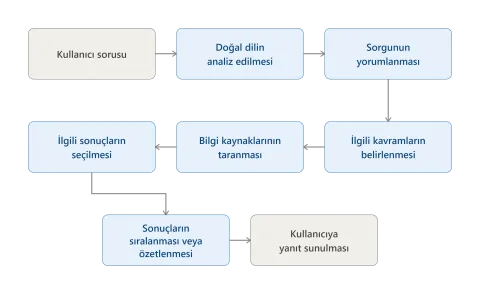
Bu yaklaşım, geleneksel bilgi erişim sistemlerinden önemli ölçüde farklılaşmaktadır. Kullanıcı artık yalnızca bir konu veya anahtar kelime girmek yerine, doğal dil kullanarak araştırma sorusunu doğrudan ifade edebilmektedir.
Örneğin: “How does artificial intelligence affect academic libraries?” gibi bir soru, yapay zekâ destekli bir sistem tarafından analiz edilerek farklı kavramlara ayrılabilir ve ilgili bilgi kaynaklarıyla ilişkilendirilebilir.
Yapay zekânın Bilgi Merkezi keşif sistemlerine entegrasyonu çeşitli potansiyel avantajlar sunmaktadır.
Doğal Dil ile Etkileşim: Kullanıcılar karmaşık Boolean sorguları oluşturmak yerine araştırma sorularını doğal dilde ifade edebilir.
Sorgu Genişletme Sistem: Kullanıcının kullandığı kavramlarla ilişkili terimleri belirleyerek daha kapsamlı bir arama gerçekleştirebilir.
Bağlamsal Arama: Arama yalnızca kelime eşleşmelerine değil, kavramlar arasındaki anlamsal ilişkilere de dayanabilir.
Bilgi Sentezi: Yapay zekâ Farklı kaynaklardan elde edilen bilgileri bir araya getirerek kullanıcıya özet niteliğinde bir yanıt sunabilir.
Araştırma Sürecinin Desteklenmesi: Kullanıcıların araştırma konularına ilişkin başlangıç noktası oluşturmalarına ve ilgili kaynakları daha hızlı keşfetmelerine yardımcı olabilir. Ancak bu avantajlar, yapay zekâ destekli sistemlerin ürettiği sonuçların sorgulanmasına gerek olmadığı anlamına gelmemektedir.
Bilgi Merkezi keşif sistemleri, kullanıcı ile bilgi kaynakları arasında bir aracılık işlevi görmektedir. Ancak bu aracılık tarafsız ve tamamen görünmez bir süreç değildir. Bir sistemin;
- hangi veri kaynaklarını indekslediği,
- hangi metadata alanlarını kullandığı,
- sorguları nasıl yorumladığı,
- sonuçları hangi kriterlerle sıraladığı,
- hangi kaynakları daha ilgili kabul ettiği kullanıcının bilgiye erişim deneyimini doğrudan etkileyebilmektedir.
Yapay zekâ teknolojilerinin bu sistemlere eklenmesiyle birlikte algoritmik aracılık daha karmaşık bir hâle gelmektedir. Çünkü sistem yalnızca mevcut kayıtları sıralamakla kalmayabilir; kullanıcı sorgusunu yeniden yorumlayabilir, kavramlar arasında ilişki kurabilir ve kaynaklardan elde edilen bilgileri sentezleyerek yeni bir metin oluşturabilir. Bu noktada kullanıcı açısından temel mesele, sistemin yalnızca ne sunduğu değil, aynı zamanda sunulan sonucun nasıl üretildiği hâline gelmektedir.
Primo VE, Ex Libris tarafından geliştirilen ve günümüzde Clarivate ürün portföyü içerisinde yer alan bir keşif aracıdır. Sistem, kullanıcıların bir bilgi merkezinin fiziksel ve dijital kaynaklarını ortak bir arayüz üzerinden keşfetmesine olanak sağlamaktadır.
Bir bilgi merkezinin bilgi kaynakları farklı sistemlerde ve farklı altyapılarda bulunabilir. Örneğin bir kullanıcı;
- basılı kitaplara,
- elektronik kitaplara,
- akademik dergi makalelerine,
- veritabanlarına,
- dijital koleksiyonlara,
- kurumsal arşiv içeriklerine,
- açık erişim kaynaklara farklı platformlar üzerinden erişebilir.
Primo VE'nin temel işlevlerinden biri, bu parçalı bilgi ortamında kullanıcıya merkezi bir keşif noktası sunmasıdır. Ancak sistem yalnızca farklı kaynakları tek bir arayüzde göstermemekte; aynı zamanda kullanıcı sorgularının işlenmesi, ilgili kayıtların bulunması ve sonuçların belirli ölçütlere göre sunulması süreçlerinde de rol oynamaktadır.
Primo VE içerisinde gerçekleştirilen bir arama, kullanıcı tarafından yapılandırılan arama kapsamına bağlı olarak farklı kaynak gruplarını içerebilir. Örneğin sistemde farklı arama kapsamları tanımlanabilmektedir:
- Yalnızca kurumun yerel koleksiyonu,
- Central Discovery Index içerisindeki içerikler,
- Yerel koleksiyon ve merkezi indeksin birlikte taranması,
- İş birliği içerisindeki diğer kurumların kaynakları.
Primo VE'nin varsayılan yapılandırmalarında IC Katalog ve Search Everything gibi farklı arama profilleri bulunmaktadır.
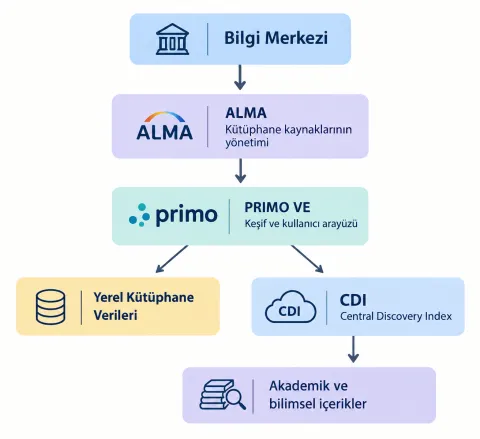
Primo VE'nin bilgi erişim mimarisi genel olarak iki temel kaynak alanı üzerinden düşünülebilir.
1. Yerel Kütüphane Verileri: Bunlar, doğrudan kurumun koleksiyonunda bulunan veya kurum tarafından yönetilen kaynakları kapsamaktadır. Örneğin: basılı kitaplar, elektronik kaynaklar, dijital koleksiyonlar, kurumsal arşiv kayıtları, yerel olarak oluşturulmuş bibliyografik kayıtlar. Bu kaynaklara ilişkin veriler, kütüphanenin kendi sistemlerinden Primo VE'ye aktarılmaktadır.
2. Central Discovery Index (CDI) İkinci önemli bileşendir. CDI, Ex Libris tarafından Primo ve Summon gibi keşif sistemlerini desteklemek amacıyla geliştirilen merkezi ve birleşik bir akademik içerik indeksidir. CDI; yayıncılar, agregatörler ve açık erişim depoları gibi farklı kaynaklardan sağlanan çok çeşitli akademik içeriği bir araya getirmektedir. CDI içerisinde: dergi makaleleri, e-kitaplar, kitap bölümleri, konferans bildirileri, gazete içerikleri, açık erişim kaynaklar gibi farklı türlerde akademik materyaller bulunabilmektedir. CDI temel olarak metadata üzerinde çalışmakla birlikte, içeriğin bir bölümü için tam metin indeksleme de yapılabilmektedir.
Bir kullanıcının Primo VE üzerinden gerçekleştirdiği aramanın kapsamını anlamak için CDI'nin rolünü bilmek önemlidir. Örneğin bir araştırmacı şu soruyu sorduğunu varsayalım:
- How does artificial intelligence affect academic libraries?
Bu sorgu yalnızca bilgi merkezinin katalog kayıtları içerisinde aranırsa sonuçlar sınırlı olabilir. Ancak arama CDI gibi geniş kapsamlı bir merkezi indeks üzerinde gerçekleştirildiğinde, farklı yayıncı ve içerik sağlayıcılardan gelen akademik kayıtlar da arama sürecine dahil edilir. CDI'nin temel işlevlerinden biri, farklı platformlarda bulunan akademik içeriklere ilişkin metadata kayıtlarını merkezi bir keşif ortamında bir araya getirmektir. Ancak burada önemli bir ayrım bulunmaktadır:
İndeksleme ≠ Tam Metne Erişim
Bir kaynağın CDI içerisinde indekslenmesi, her kullanıcının o kaynağın tam metnine erişebileceği anlamına gelmez. Bir kullanıcının tam metne erişebilmesi; kurumun abonelikleri, lisans anlaşmaları, açık erişim durumu, içerik sağlayıcının erişim koşulları gibi faktörlere bağlıdır. Bu nedenle bir web keşif aracının geniş bir indeks üzerinde arama yapabilmesi ile kullanıcının bulunan her kaynağa erişebilmesi aynı durum değildir.
Kullanıcı açısından Primo VE'de süreç oldukça basit görünmektedir: Arama kutusuna sorgu yazılır ve sonuçlar görüntülenir. Ancak arka planda daha karmaşık bir bilgi erişim süreci bulunmaktadır. Bu süreç basitleştirilmiş biçimde:
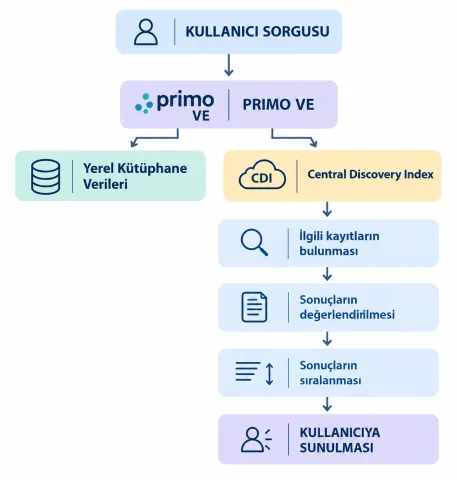
Bu süreçte kullanıcı yalnızca sonuç ekranını görmektedir. Ancak sonuçların ortaya çıkmasında;
- hangi veri kaynaklarının tarandığı,
- hangi kayıtların sorguyla eşleştirildiği,
- aynı içeriğe ait farklı kayıtların nasıl birleştirildiği,
- hangi sonuçların daha ilgili kabul edildiği,
- sonuçların hangi kriterlerle sıralandığı gibi birden fazla sistemsel süreç etkili olabilmektedir.
CDI, farklı kaynaklardan gelen aynı veya benzer kayıtlara ilişkin verileri tekilleştirme ve birleştirme mekanizmalarından da yararlanmaktadır. Bu durum, kullanıcının aynı akademik kayda ait çok sayıda yinelenen sonuçla karşılaşmasını azaltmayı amaçlamaktadır.
Primo VE, kullanıcı deneyimi açısından genel amaçlı arama motorlarına benzer bir yapı sunabilir. Ancak çalışma bağlamı ve veri kaynağı bakımından Google gibi genel web arama motorlarından farklıdır. Genel web arama motorları, erişebildikleri web ortamındaki içerikleri indekslemeye çalışırken Primo VE, öncelikle kütüphane tarafından yönetilen veya erişim sağlanan kaynaklar ile CDI kapsamındaki akademik içerikler üzerinde çalışmaktadır. Bu nedenle Primo VE'de kullanıcıların karşılaştığı sonuçlar: İnternet üzerindeki tüm bilginin değil, sistemin erişebildiği ve indekslediği bilgi kaynaklarının bir yansımasıdır.
Bu ayrım, algoritma okuryazarlığı açısından kritik öneme sahiptir. Çünkü bir sistemin ürettiği sonucun kalitesi değerlendirilirken yalnızca algoritmanın nasıl çalıştığı değil, algoritmanın hangi veri kaynağı üzerinde çalıştığı da dikkate alınmalıdır.
Primo VE'nin temel amacı kullanıcıların bilgi kaynaklarını keşfetmesini sağlamaktır. Ancak bu süreç tamamen pasif bir kayıt listeleme işlemi değildir. Sistem, kullanıcı sorgusunu belirli arama mekanizmaları aracılığıyla işler ve elde edilen sonuçları çeşitli kriterlere göre sunar. Örneğin arama sürecinde:
- sorgu terimleri,
- metadata alanları,
- kaynak türü,
- erişilebilirlik,
- arama kapsamı,
- ilgili sonuçların sıralanması gibi faktörler etkili olabilir.
Bu nedenle bir kullanıcının ekranında gördüğü sonuç listesi, yalnızca mevcut kaynakların rastgele bir listesi değildir. Sonuçlar, belirli bilgi erişim ve sıralama mekanizmalarının sonucunda oluşturulmaktadır. Bu noktada algoritma okuryazarlığı açısından temel soru yeniden ortaya çıkmaktadır: Bir sonuç listesinde ilk sırada görülen kaynak gerçekten en iyi kaynak mıdır, yoksa sistem tarafından belirli kriterlere göre en görünür hâle getirilen kaynak mıdır? Bu soru, özellikle yapay zekâ destekli araçların keşif sistemlerine eklenmesiyle daha önemli hâle gelmektedir.
Primo VE'nin geleneksel işlevi, kullanıcıların geniş bir bilgi evreni içerisinde arama yapmasına ve ilgili kaynakları keşfetmesine olanak sağlamaktır. Ancak yapay zekâ destekli yeni araçlarla birlikte bu süreç farklı bir aşamaya taşınmaktadır. Geleneksel modelde:
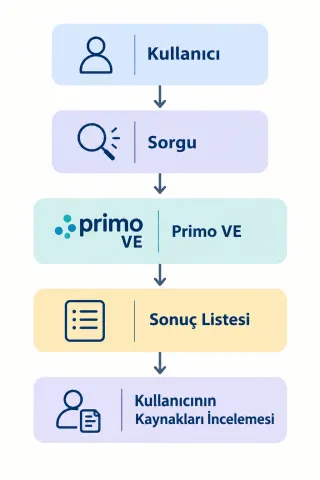
Yapay zekâ destekli modelde ise süreç şu şekilde genişlemektedir:
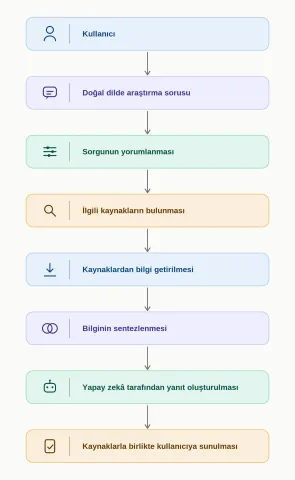
Bu dönüşüm, web keşif araçlarının rolünü değiştirmektedir. Sistem artık yalnızca “kaynak bulan” bir araç olmaktan çıkarak, belirli kaynaklara dayanarak “araştırma sorusuna yanıt oluşturmaya yardımcı olan” bir yapıya doğru gelişmektedir. Primo VE'nin bu dönüşüm içerisindeki yapay zekâ destekli bileşeni ise Primo Research Assistant'tır.
Primo Research Assistant, Primo VE içerisine entegre edilen üretken yapay zekâ destekli bir araştırma aracıdır. Kullanıcıların geleneksel anahtar kelime aramalarının yanı sıra, araştırma sorularını doğal dilde ifade ederek akademik kaynaklar arasında keşif yapabilmesini amaçlamaktadır. Sistem, kullanıcının sorusunu analiz ederek Central Discovery Index (CDI) içerisindeki ilgili kaynakları belirler ve seçilen kaynaklardan yararlanarak kaynaklandırılmış bir yanıt oluşturur. Bu yönüyle Primo Research Assistant, geleneksel keşif sistemlerinde görülen: Sorgu - Sonuç listesi modelini, Araştırma sorusu - Kaynakların belirlenmesi - Bilginin sentezlenmesi - Kaynaklandırılmış yanıt modeline doğru genişletmektedir.
Research Assistant, Ex Libris tarafından bilgi merkezlerinin keşif sistemlerinde üretken yapay zekâ kullanımına yönelik olarak geliştirilmiştir. Araç ilk olarak Haziran 2024'te beta programı kapsamında belirli kurumların kullanımına sunulmuştur. Beta sürecinde farklı ülkelerden üniversite ve araştırma kurumlarının geri bildirimleri doğrultusunda sistemin işlevleri değerlendirilmiştir. Eylül 2024'te Primo kurumlarının kullanımına açılan Primo Research Assistant, doğal dilde araştırma sorularına yanıt verme, ilgili akademik kaynakları belirleme ve kaynaklara dayalı özet yanıtlar oluşturma yaklaşımıyla Primo keşif ortamının yeni bir bileşeni hâline gelmiştir.
Primo Research Assistant'ın temel amacı araştırmacının yerine araştırma yapmak değildir. Araç, özellikle araştırma sürecinin başlangıç aşamasında kullanıcılara konu hakkında genel bir çerçeve sunmayı ve ilgili akademik kaynakları keşfetmeyi desteklemektedir. Bu nedenle sistem tarafından oluşturulan yanıtların nihai bilgi kaynağı olarak değil, kaynaklara yönlendiren bir araştırma başlangıç noktası olarak değerlendirilmesi önemlidir.
Primo Research Assistant ile birlikte web keşif aracı yalnızca kaynakları listeleyen bir yapı olmaktan çıkarak, kaynakları seçen ve bu kaynaklardan yararlanarak kullanıcıya yeni bir metin sunan bir yapıya dönüşmektedir. Bu durum, algoritma okuryazarlığı açısından yeni soruları beraberinde getirmektedir: Sistem hangi kaynakları seçmektedir? Neden bazı kaynaklar diğerlerine göre önceliklendirilmektedir? Kaynaklardaki bilgiler nasıl sentezlenmektedir? Oluşturulan yanıt ne ölçüde kaynakları doğru temsil etmektedir? Bu sorular, Primo Research Assistant'ın teknik çalışma mantığının anlaşılmasını gerekli kılmaktadır.
Primo Research Assistant, kullanıcının sorusuna yalnızca büyük dil modelinin mevcut bilgisine dayanarak yanıt üretmez. Bunun yerine, Retrieval-Augmented Generation (RAG) olarak adlandırılan yaklaşımı kullanarak ilgili akademik kaynakları araştırma sürecine dahil eder. RAG yaklaşımı iki temel aşamadan oluşur:
1. Retrieval (Bilginin Getirilmesi): Kullanıcının araştırma sorusu analiz edilir ve Central Discovery Index (CDI) içerisinde ilgili akademik kaynaklar aranır.
2. Generation (Yanıtın Oluşturulması): Belirlenen kaynaklardan elde edilen bilgiler, büyük dil modeli tarafından işlenerek kullanıcıya doğal dilde bir yanıt oluşturulur.
Bu yaklaşımın temel amacı, yapay zekâ tarafından oluşturulan yanıtın belirli akademik kaynaklara dayandırılmasıdır. Ancak burada önemli bir nokta bulunmaktadır: RAG mimarisi, yapay zekânın hata yapma olasılığını tamamen ortadan kaldırmaz. Yanıtın niteliği; sistemin erişebildiği kaynaklara, seçilen belgelerin uygunluğuna ve büyük dil modelinin bu bilgileri nasıl yorumladığına bağlıdır. Dolayısıyla RAG, yapay zekânın yanıtını kaynaklarla ilişkilendirir; ancak oluşturulan yanıtın eleştirel biçimde değerlendirilmesi gerekliliğini ortadan kaldırmaz.
Primo AI Research Assistant'ın çalışma mantığını somutlaştırmak için “İklim değişikliğinin göç üzerindeki etkileri nelerdir?” araştırma sorusunu inceleyelim. Bu örnek, kullanıcının sisteme yalnızca tek bir soru yöneltmesine rağmen, arka planda birden fazla algoritmik işlemin gerçekleştiğini göstermektedir.
Kullanıcı doğal dilde şu soruyu yöneltir: “İklim değişikliğinin göç üzerindeki etkileri nelerdir?” Kullanıcının bu aşamada Boolean operatörleri, eş anlamlılar veya akademik anahtar kelimeler belirlemesi gerekmez.
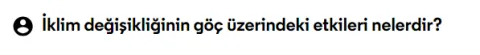
Research Assistant, soruyu doğrudan olduğu gibi aramak yerine farklı kavram ve ifadelerle genişletir. Örneğin oluşturulan sorguda:
- climate change migration effects
- impact of climate change on migration
- human migration
- environmental migration
- population displacement
- iklim değişikliği
- göç
- göç etkileri gibi farklı ifadeler görülmektedir.
Sorgu içerisinde OR ve AND gibi Boolean operatörleri de kullanılmaktadır. Bu aşama algoritma okuryazarlığı açısından özellikle önemlidir. Çünkü kullanıcı yalnızca bir soru sormuş olsa da sistem, hangi kavramların ilişkili olduğunu ve hangi alternatif ifadelerin aranacağını belirleyerek arama kapsamını değiştirmektedir. Kullanıcının yazdığı soru ile sistemin gerçekleştirdiği arama aynı şey değildir.
Örnekte sistem tarafından oluşturulan sorgu oldukça geniştir:
- (climate change migration effects) OR (impact of climate change on migration) OR ((climate change) AND (human migration)) OR ((climate change) OR (environmental migration)) OR (effects of climate change on population displacement) OR (iklim değişikliği göç etkileri) OR (iklim değişikliği) OR (göç nedenleri) OR ((iklim değişikliği) OR (göç)) OR ((iklim değişikliği) AND (göç etkileri)) OR (İklim değişikliğinin göç üzerindeki etkileri nelerdir?)

Bu sorgu, tek bir anahtar kelime aramasından çok daha geniş bir arama gerçekleştirilmesini sağlar. Ancak burada kullanıcı açısından kritik bir soru ortaya çıkar: Sistem sorguyu genişletirken doğru kavramsal ilişkileri kurdu mu? Örneğin sorguda “climate change” ve “migration” kavramlarının bazı bölümlerde OR ile ilişkilendirilmesi, arama kapsamını oldukça genişletebilir. Bu nedenle algoritmik sorgu genişletme, sonuç sayısını artırırken aynı zamanda konuyla doğrudan ilişkili olmayan içeriklerin de sonuçlara girmesine neden olabilir.
Oluşturulan sorgu Central Discovery Index (CDI) üzerinde çalıştırılır. Sistem bu arama sonucunda ilgili olduğunu değerlendirdiği akademik kaynakları belirler. Örnekte seçilen beş kaynak şunlardır:
- İklim Değişikliğine Bağlı Su Kıtlığı ve Zorunlu Göç: Türkiye’nin Güneydoğusunda Suriyeli Kadın Göçmenlerin Kırılganlıkları — Baykal, 2026
- İklim Değişikliği ve Göç: Oğuzların Mâverâünnehir ve İran’a Göçleri — Küçükbekir vd., 2024
- İklim değişikliği konferansları sonuç belgelerinin göç bağlamında analizi — Çelikyay vd., 2026
- İklim Göçünün Anlatılarını İnşa Etmek: Türk Haber Medyasında İklim Değişikliği ve Göç Söyleminin Analizi — Pazarbaşı, 2024
- İklim Değişikliğine Bağlı Göçlerin Kadınlar Üzerindeki Etkileri — Karaman vd., 2025
Burada dikkat edilmesi gereken önemli nokta şudur: CDI'de bulunan bütün kaynaklar, oluşturulan yanıtın içerisinde kullanılmaz. Sistem, yanıt oluşturmak üzere belirli kaynakları seçer.
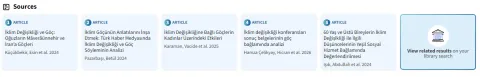
Research Assistant daha sonra seçtiği kaynaklardan elde ettiği bilgileri bir araya getirir. Örnekte beş kaynak farklı perspektifler sunmaktadır:
Baykal (2026) Su kıtlığı ve zorunlu göç, Küçükbekir vd. (2024) Tarihsel ve çevresel faktörler, Çelikyay vd. (2026) Uluslararası politika, Pazarbaşı (2024) Medya ve toplumsal algı, Karaman vd. (2025) Toplumsal cinsiyet
Bu durum bize algoritmanın yalnızca “kaynak bulmadığını”, aynı zamanda araştırma sorusuna ilişkin bir kaynak seçimi ve temsil süreci gerçekleştirdiğini gösterir. Örneğin farklı bir beş kaynak seçilmiş olsaydı, oluşturulan yanıtın vurguladığı konular da değişebilirdi.
Seçilen kaynaklardan elde edilen bilgiler yapay zekâ tarafından işlenerek bir “Overview of sources” oluşturulur. Aşağıdaki örnekte sistem:
- su kıtlığı,
- kuraklık,
- tarımsal verimlilik,
- ekonomik koşullar,
- toplumsal cinsiyet,
- göç politikaları,
- medya temsilleri gibi farklı temaları bir araya getirerek bütüncül bir açıklama üretmektedir.
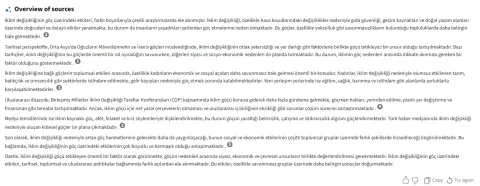
Burada ortaya çıkan metin, beş makalenin art arda sıralanması değildir. Yapay zekâ, kaynaklardan elde edilen bilgileri özetleyerek ve sentezleyerek yeni bir anlatı oluşturur. Bu nedenle kullanıcı açısından önemli soru şudur: “Bu cümle gerçekten kaynakta var mı, yoksa yapay zekânın kaynaklardan çıkardığı bir yorum mu?”
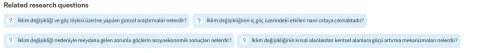
Örnekte sistem yalnızca yanıt üretmemekte, aynı zamanda yeni araştırma soruları önermektedir:
- İklim değişikliği ve göç ilişkisi üzerine yapılan güncel araştırmalar nelerdir?
- İklim değişikliğinin kırsal alanlardan kentsel alanlara göç üzerindeki etkileri nasıl ortaya çıkmaktadır?
- İklim değişikliği nedeniyle zorunlu göç eden toplulukların sosyoekonomik durumları nasıldır?
- İklim değişikliğinin göç politikaları ve yönetimi üzerindeki etkileri nelerdir?
Bu özellik, algoritmik aracılığın başka bir boyutunu göstermektedir. Sistem yalnızca “soruya ne cevap vereyim?” şeklinde değil, aynı zamanda “kullanıcı bundan sonra neyi araştırabilir?” sorusuna da üretmektedir. Dolayısıyla yapay zekâ destekli keşif sistemleri, kullanıcının araştırma sürecinin yönünü de etkileyebilir.
Bu tek örnek üzerinden kullanıcı şu soruları sorabilir:
- Sorgu: Sistem sorumu nasıl yorumladı ve hangi terimleri ekledi?
- Kapsam: Hangi kaynakları taradı ve hangileri kapsam dışında kaldı?
- Seçim: Neden özellikle bu beş kaynak seçildi?
- Sentez: Yapay zekâ kaynaklardaki bilgileri doğru biçimde aktardı mı?
- Görünürlük: Seçilmeyen kaynaklarda farklı veya çelişkili bilgiler olabilir mi?
- Sonraki araştırma: Sistemin önerdiği araştırma soruları benim araştırma yönümü etkiliyor mu?
Bu örnekte kullanıcı yalnızca tek bir soru sormuştur. Ancak karşılığında: sorgu genişletme, Boolean sorgusu, CDI araması, kaynak seçimi, bilgi sentezi, Yanıt, yeni araştırma soruları şeklinde bir algoritmik süreç gerçekleşmiştir. Algoritma okuryazarlığı, bu süreci görünür kılmayı ve kullanıcının her aşamada “neden?” sorusunu sorabilmesini sağlar.
Primo AI Research Assistant, tüm interneti veya Primo VE’deki tüm kayıtları tarayan bir sistem değildir. Yanıtlarını temel olarak Central Discovery Index (CDI) içerisindeki kayıtların metadata ve özetlerinden oluşturur. Bu nedenle sistemin ürettiği yanıt, CDI’nin kapsamı ve içerik sağlayıcılarının katılımıyla doğrudan ilişkilidir.
Sistem, CDI’de bulunan ve yeterli metadata ile özete sahip akademik içerikleri kullanır. Ancak bazı içerikler Primo AI Research Assistant kapsamının dışında tutulur:
- Haber içerikleri,
- Yeterli metadata veya özeti bulunmayan kaynaklar,
- Geri çekilmiş (retracted) veya yayından kaldırılmış belgeler,
- Bazı abonelik tabanlı A&I koleksiyonları,
- DataCite, Elsevier, JSTOR içerikleri ve bu sağlayıcılardan gelen bazı toplu içerikler.
Bu istisnalar zaman içinde değişebilir; Clarivate, içerik sağlayıcılarla yapılan görüşmelere bağlı olarak kapsamın güncellenebileceğini belirtmektedir.
Güvenilirlik Açısından Primo AI Research Assistant
Primo AI Research Assistant, yanıtlarını kaynaklara dayandırmaya ve kullanılan kaynakları göstermeye çalışsa da oluşturulan yanıt doğrudan akademik kaynağın kendisi değildir. Yanıt, seçilen kaynakların özetlerinden yapay zekâ tarafından oluşturulur. Bu nedenle kullanıcı: “Bu yanıt doğru mu?” kadar “Bu yanıt hangi kaynaklara ve hangi içerik kapsamına dayanıyor?” sorusunu da sormalıdır. Bu, algoritma okuryazarlığının temel noktalarından biridir: Bir sistemin kaynak göstermesi, ürettiği yorumun otomatik olarak doğru olduğu anlamına gelmez.
Yapay zekâ destekli keşif sistemlerinde yalnızca bilgi kaynaklarının değil, kullanıcı verilerinin nasıl işlendiğinin de anlaşılması gerekir. Primo Research Assistant kullanılırken sorguların ve sistemle gerçekleştirilen etkileşimlerin nasıl işlendiği, algoritma okuryazarlığının önemli bir parçasıdır. Sistemin yapay zekâ kullanması, kullanıcıların kişisel bilgilerinin veya araştırma geçmişlerinin sınırsız biçimde kullanıldığı anlamına gelmez. Bununla birlikte kullanıcıların, kullandıkları platformun veri işleme, saklama ve gizlilik politikalarını incelemeleri önemlidir.
Yapay zekâ tarafından oluşturulan araştırma yanıtları:
- Kaynakların kendisinin yerine geçmez.
- Hatalı veya eksik bilgi içerebilir.
- Kullanılan kaynakların kapsamı ve seçimiyle sınırlıdır.
- Akademik kararların tek başına dayanağı olmamalıdır.
Bu nedenle kullanıcı, oluşturulan yanıtı ilgili kaynaklara ulaşarak doğrulamalı ve özellikle akademik çalışmalarda birincil kaynağı incelemelidir.
Yapay zekâya güvenmek, yapay zekâyı sorgulamamak anlamına gelmez.
Algoritma okuryazarı kullanıcı, yalnızca “Sistem ne yanıt verdi?” sorusunu değil, “Bu yanıt hangi verilerle, hangi kaynaklarla ve hangi süreçle oluşturuldu?” sorusunu da sorar.